ElevenLabs presentó sus nuevos modelos de voz v4 y v4 Turbo, cuya característica central redefiniría el estándar del sector: la inteligencia artificial solo necesita 10 segundos de audio para clonar la voz de cualquier humano. Esa capacidad se suma a un mayor control expresivo, menor latencia y soporte para más de 90 idiomas. La compañía busca ampliar su presencia en sectores como servicios empresariales, producción de contenidos y atención al cliente.
Clonación de voz con solo 10 segundos de audio: cómo funciona
La nueva arquitectura de ElevenLabs permite generar audio con apenas 10 segundos de muestra vocal, según indica la compañía. Esto representa una reducción drástica frente a los requerimientos habituales de clonación de voz en el sector.
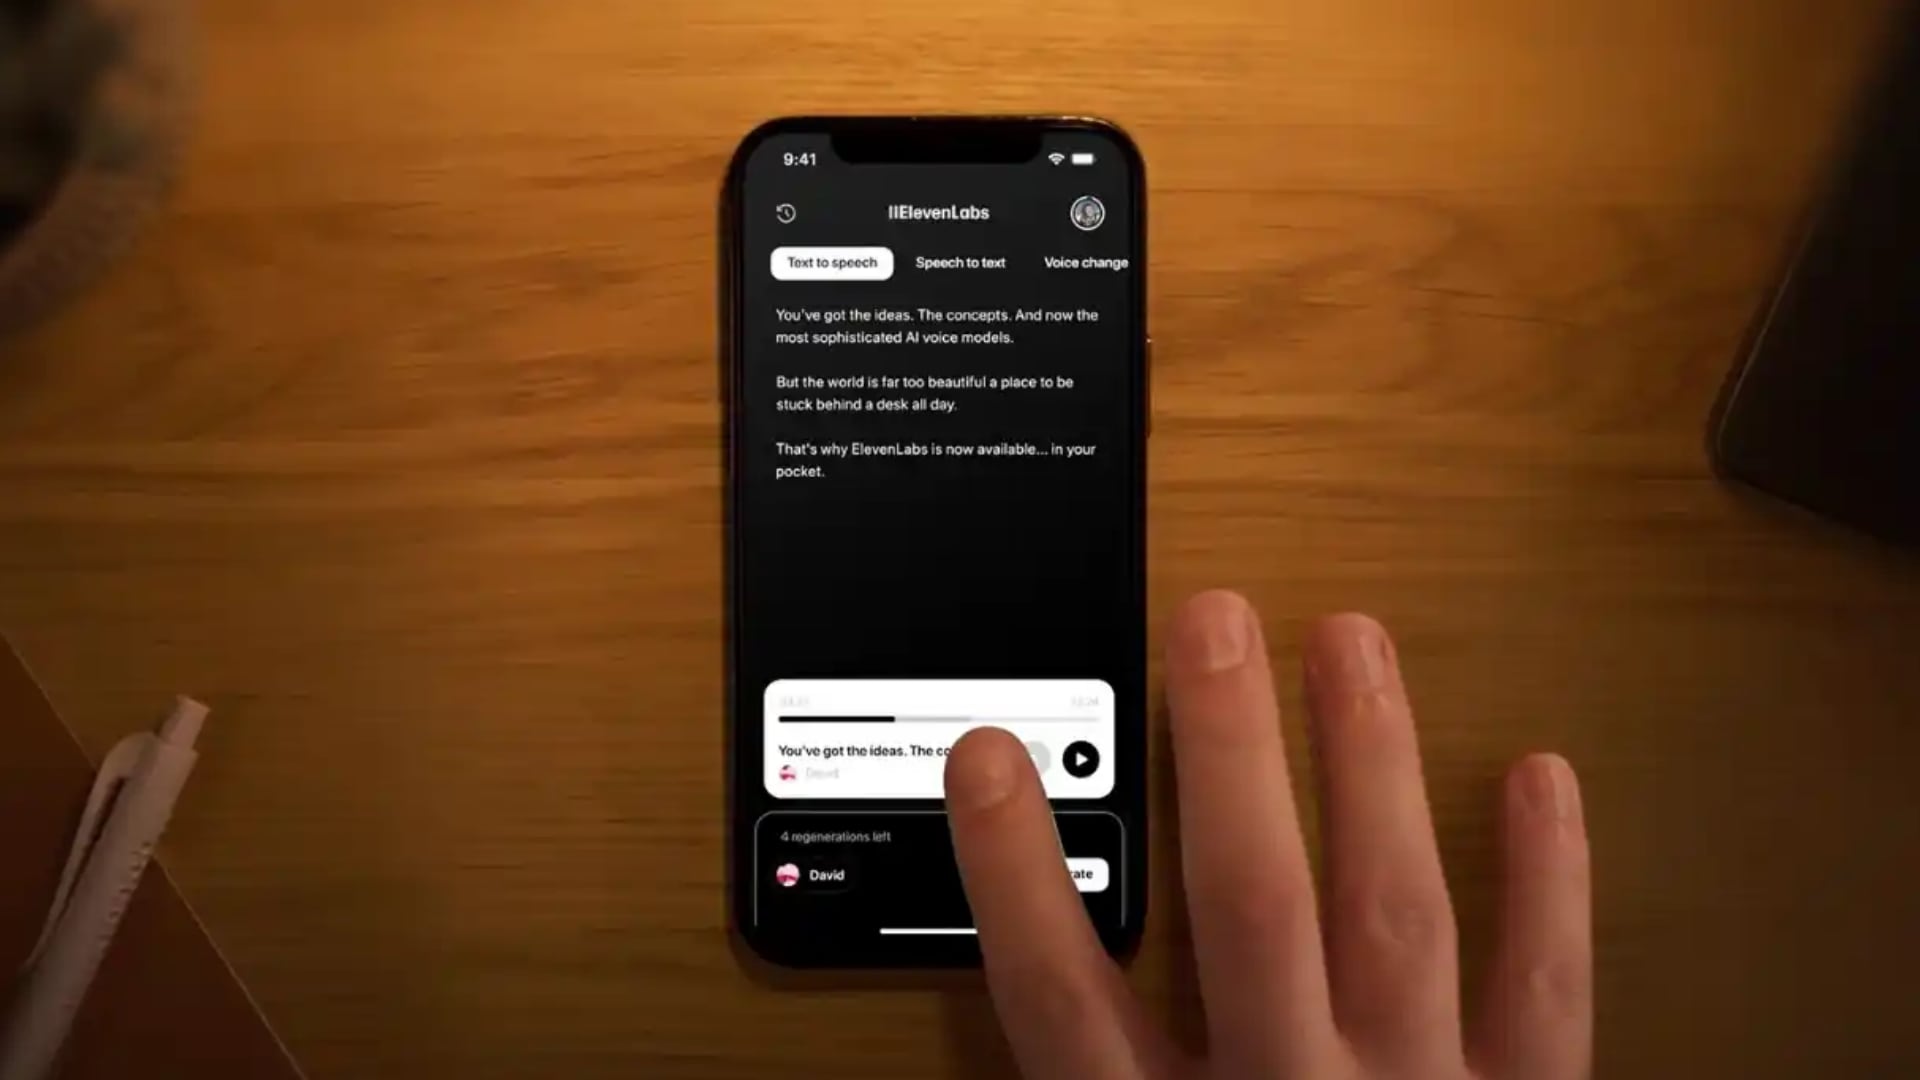
El sistema no solo replica el timbre con una muestra breve, sino que mantiene mejor la identidad vocal incluso en textos largos, un problema recurrente en generaciones anteriores donde la voz tendía a perder consistencia a medida que avanzaba el audio.
Este avance en la clonación de voz basada en IA tiene aplicaciones directas en doblaje, accesibilidad y producción de contenido, ya que reduce el tiempo y los recursos necesarios para crear una réplica vocal funcional.
La clonación de voz con inteligencia artificial permite reproducir el timbre y las particularidades de una persona a partir de una grabación mínima. Con los modelos de ElevenLabs, basta con 10 segundos de audio para que el sistema genere nuevas frases con esa misma identidad vocal, incluso en pasajes extensos.

Control expresivo y voces que dirigen la interpretación
La versión anterior de la compañía ya incorporaba etiquetas para controlar expresiones en el audio generado. Con v4, la compañía amplía esas instrucciones y permite combinarlas en secuencia dentro de una misma pieza.
Esto habilita, por ejemplo, que un creador solicite una lectura que comience con tono calmado, avance hacia un registro entusiasta y cierre con una pausa más contenida. En audiolibros, formación corporativa o publicidad, ese tipo de matices distingue una narración funcional de una que suena artificial.
El desarrollo marca un cambio de enfoque en la voz sintética: los sistemas dejan de limitarse a imitar timbres y comienzan a dirigir interpretación, ritmo y contexto. Ese salto resulta relevante porque acerca la tecnología a flujos de trabajo profesionales donde no alcanza con leer un texto, sino que se requiere transmitir una intención específica.
Agentes conversacionales con menor latencia
ElevenLabs también apunta al desarrollo de agentes conversacionales mediante v4 Turbo. Según informó TechCrunch, el modelo puede comenzar a generar audio en cuanto el modelo de lenguaje produce una respuesta, lo que reduce los tiempos muertos durante una conversación.
La compañía destaca además que el sistema maneja de forma diferenciada escaladas, esperas y situaciones de conflicto, elementos que resultan críticos en contextos de soporte telefónico o ventas, donde el ritmo y el tono de la respuesta influyen en la experiencia del usuario.
Expansión de idiomas para contenido global
El soporte lingüístico de ElevenLabs crece de 70 a más de 90 idiomas, con mejoras específicas en japonés, portugués brasileño, mandarín y cantonés. Para empresas con operación multinacional, esta ampliación reduce la necesidad de contratar soluciones separadas por cada mercado.

Para creadores individuales, el avance abre la posibilidad de generar versiones localizadas de videos, podcasts o cursos con voces más naturales y consistentes entre idiomas.
El avance de la empresa abarata y acelera la localización de contenido, pero también eleva las exigencias en materia de autenticidad y consentimiento. Clonar una voz a partir de pocos segundos de audio resulta útil para doblaje y accesibilidad, aunque el mismo mecanismo facilita usos abusivos cuando no existen permisos claros ni sistemas de detección adecuados.